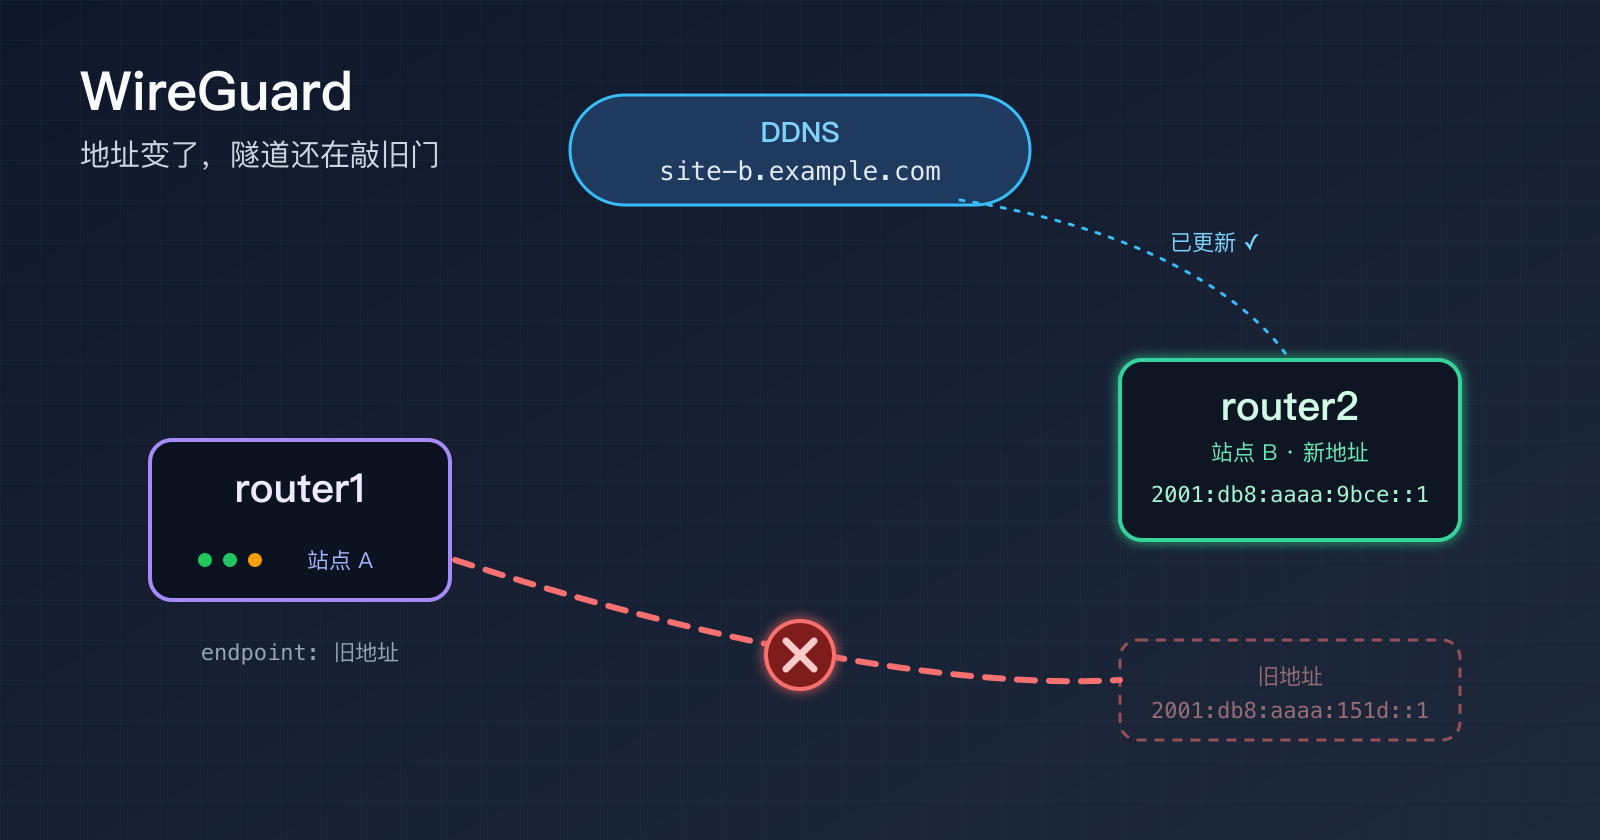
两台 OpenWrt 路由器 router1(站点 A)与 router2(站点 B),通过 IPv6 建立 WireGuard 隧道,两端都是运营商下发的动态公网 IPv6,靠 DDNS 互相找到对方。某天隧道突然断了,这里记录排查过程和修复方法。
先说结论:router2 的公网 IPv6 变化后,DDNS 已经更新,但 router1 的 WireGuard 运行状态里仍保留着旧的端点地址。刷新 router1 上 site-b 对端的 endpoint 后,立即握手成功,隧道恢复。
文中的域名、公网地址、公钥均已替换为示例值,请按自己的环境替换。
1 先尝试快速恢复
在电脑终端登录 router1:
| |
以下命令在 router1 的 SSH 会话内执行。先查看当前端点,再通过域名重新解析 site-b 的地址:
| |
成功标准:site-b 对端出现近期 latest handshake,接收流量增加,隧道地址 192.168.10.2 和 LAN 地址 192.168.2.1 能 ping 通。刚开始的几次 ping 可能在等待握手,恢复后再测一次。
这条 wg set 只刷新运行中的对端地址,不修改 UCI 持久配置,不需要重启 WireGuard 或路由器。域名解析失败时,先解决 DNS,不要直接填写历史 IPv6。
如果已确认 DDNS 指向 router2 当前地址,刷新后仍不通,请继续看第 5 节排查,不能直接认定原因相同。
2 设备与对端对应关系
| 项目 | router1 | router2 |
|---|---|---|
| 对端描述 | site-a | site-b |
| 电脑上的 SSH 别名 | router1 | router2 |
| LAN 地址 | 192.168.1.1 | 192.168.2.1 |
| 隧道地址 | 192.168.10.1 | 192.168.10.2 |
| DDNS | site-a.example.com | site-b.example.com |
| WireGuard 接口 | wireguard | wireguard |
| UDP 监听端口 | 51820 | 51820 |
| 本次公网出口设备 | eth2 | eth2 |
wg set 需要用公钥选中正确的 peer(公钥不是私钥):在 router1 上修复 site-b 对端,要使用 router2 的公钥;在 router2 上修复 site-a 对端,要使用 router1 的公钥。如果设备重新生成过密钥,以当前 wg show 结果为准。
3 本次故障记录
现象和证据
- router2 上 site-a 对端没有成功握手,接收为
0 B,持续发送握手请求。 - router1 与 router2 各自连接另一个第三方对端都正常,说明两台设备的 WireGuard 和 IPv6 出口并非全面故障。
- router1 的公网 IPv6 与 site-a 域名解析一致,监听端口正常,双方公钥配置匹配,防火墙存在 UDP 放行规则。
- router1 的 site-b 运行端点仍为旧地址,但 site-b 域名已解析到新地址。
| |
可以看到运营商重新分配了前缀,接口标识没变,而 router1 一直往旧地址发包。以上地址仅用于说明,不可作为修复时的固定地址。
实际处理和结果
将 router1 内存中的 site-b endpoint 更新为当时的新 IPv6,随后抓包看到握手请求和响应,latest handshake 更新,收发流量增加。
- router1 →
192.168.10.2:3 次 ping 全通,稳定后约 57~73 ms。 - router1 →
192.168.2.1:2 次 ping 全通,约 53~74 ms。 - 未修改持久网络配置,未重启接口。
关键点:DDNS 更新不会自动让运行中的 WireGuard endpoint 同步更新。WireGuard 只在配置加载时解析一次域名,之后就一直使用解析出的 IP;persistent_keepalive=25 只用于保活,并不等于每 25 秒重新解析域名。
为什么没有自动恢复
按理说,只要一方知道对方的真实地址就够了。WireGuard 支持漫游:一端收到对端发来、能通过密钥验证的包时,会自动把该对端的 endpoint 改成这个包的来源地址。所以只要一方能把握手包送到另一方,另一方回包时就“学会”了新地址,不需要自己去解析 DDNS。
本次只有 router2 的地址变了,router1 的地址没变。router2 记录的 router1 地址是正确的,也一直在发握手请求。如果这些请求能到达 router1,router1 就会学到 router2 的新地址,隧道本应自行恢复。实际上 router2 一直是 0 B received,直到在 router1 上手动刷新才恢复,说明 router2 → router1 这个方向没有走通。
本次没有抓到这一段的包,原因只能推测:
- router1 上游有状态防火墙(光猫或运营商侧):只放行内部先向外发起过的流量。router1 一直往旧地址发包,没有为 router2 的新地址“开门”,router2 主动发来的包就被挡在外面;router1 改为向新地址发包后,回程随即放行,立刻握手成功。这个解释与现象最吻合。
- router2 的源地址选错:接口上有多个 IPv6 地址,或被代理的策略路由带偏,导致发出的包源地址不符合预期。
- router1 本机防火墙或 zone 配置问题:只确认了放行规则存在,没有抓包证明报文确实到达。
下次遇到同样的情况,可以先不急着刷新,在 router1 的 eth2 上抓包,看 router2 的握手请求是否到达:没到达,就是上游的问题;到达了但没有回应,就查本机。
这也是本文要求核对两端 DDNS 的原因。它不是建立连接的必要条件,而是为了排查和恢复都更稳:
- 事先不知道哪一端的地址变了,两端都可能变。
- 不知道哪个方向能主动打通。本次只能由 router1 发起;如果下次换成 router1 地址变化、router2 又记着旧地址,两边就都连不上了。
- 漫游学到的地址只在运行时有效,重启接口或设备后,endpoint 会回到配置中的域名,此时仍需依赖 DDNS。
- watchdog 同样是靠重新解析 DDNS 来修复,域名不对它也无能为力。
4 防止动态地址变化后再次断连
OpenWrt 的 wireguard-tools 自带了 /usr/bin/wireguard_watchdog 脚本,但默认不会定时执行。
脚本会检查已启用、有域名端点且开启 keepalive 的对端。当距离上次握手超过 150 秒时,重新解析域名并更新 endpoint。每分钟执行一次,就能在持续失联后自动刷新;实际恢复时间还取决于 DDNS 和 DNS 缓存的更新速度。
检查并启用定时任务
以下在 需要启用此功能的路由器 SSH 会话内执行,先检查:
| |
确认脚本存在,并且没有其他等效的端点刷新任务后,备份 crontab 并添加任务。下面的命令会保留已有任务,并避免重复添加:
| |
可手动执行一次并查看日志:
| |
健康的对端会被跳过,没有新日志不一定代表脚本没运行。脚本依赖 DDNS 正确;如果域名本身仍指向旧地址,watchdog 也无能为力。
两端都是动态地址时,建议两台路由器都启用,但应先登录检查脚本是否存在,不要假定两台设备安装的软件完全相同。
5 快速恢复无效时继续排查
第一步 区分没有握手与握手后业务不通
在故障路由器执行:
| |
- 没有
latest handshake,或握手长时间不更新:优先查端点地址、网络可达性、防火墙和密钥。 - 有近期握手但访问不了 LAN:继续查 AllowedIPs、路由、转发规则和目标主机防火墙。
0 B received说明本机没有收到被 WireGuard 接受并计入该对端的流量;是否有原始报文到达,需要抓包确认。
第二步 对照 DNS、运行端点和实际地址
在 router1:
| |
在 router2:
| |
还需要在 router1 执行 ip -6 addr show dev eth2,核对 site-a 域名是否等于 router1 的当前公网地址。
判断方法:
- DNS 与目标设备当前公网地址不同:检查目标端 DDNS 更新程序及 DNS 缓存。
- DNS 正确,但运行中的 endpoint 是旧的:执行第 1 节的
wg set,或运行 watchdog。 - 三者一致仍无法握手:继续查数据包和网络路径。
如果出口已经不是 eth2,用实际出口替换命令中的设备名。
第三步 必要时从另一端刷新
在电脑上执行 ssh router2,然后在 router2 的 SSH 会话内执行:
| |
两端都使用动态 IPv6 时,失联的一侧或两侧都可能保留旧地址。SSH 无法从电脑直连时,可使用设备的本地管理网络或其他已有管理通道;不要先重启整个网络,以免丢失管理连接。
第四步 抓取短时握手包
在路由器上将 目标当前IPv6 替换为实际地址后执行,按 Ctrl+C 停止:
| |
最好两端同时抓包。握手请求的 UDP 载荷通常长 148 字节,响应长 92 字节;长度仅用于辅助识别,最终以握手状态为准。
| 抓包现象 | 下一步 |
|---|---|
| 本端持续发请求,目标端完全看不到 | 核对目标地址、上游路由和防火墙 |
| 目标端收到请求但不发响应 | 检查本机防火墙、监听端口、公钥及预共享密钥配置 |
| 目标端发出响应,本端收不到 | 检查回程路径及两侧上游防火墙 |
| 双向有包但握手失败 | 继续核对双方密钥、系统时间和报文是否属于正确对端 |
IPv6 ping 不通既不能单独证明设备离线,也不能单独证明 WireGuard 的 UDP 端口不通。
第五步 查看防火墙和路由
| |
确认实际公网出口属于正确的防火墙 zone,入站允许 IPv6 UDP 监听端口。使用 OpenClash 等代理时,检查 WireGuard 外层 UDP 是否被正确放行,以及到公网端点的路由是否走实际出口。
本例中 router1 的 site-b peer 允许网段为 192.168.2.0/24 与 192.168.10.2/32;router2 的 site-a peer 为 192.168.1.0/24 与 192.168.10.1/32。握手后 LAN 不通时,再核对这些网段和防火墙转发。
6 修复后记录
每次处理后建议记录以下内容,方便区分地址变化与其他故障:
- 故障时间和影响范围。
- 两台设备当前公网 IPv6、DDNS 解析值、WireGuard 运行端点。
- 修改了哪台设备、哪一个 peer,执行了什么命令。
- 修复后的握手时间、收发流量、隧道和 LAN ping 结果。
- 是否仅刷新运行状态,是否添加或修改了持久配置。
查看或分享配置时不要公开私钥、预共享密钥和 DDNS 令牌。wg show 默认隐藏私钥,但不要把 wg showconf 或完整网络配置直接发到公开渠道。